
GPT-5.6 Luna подешевела на 80%: новые цены OpenAI
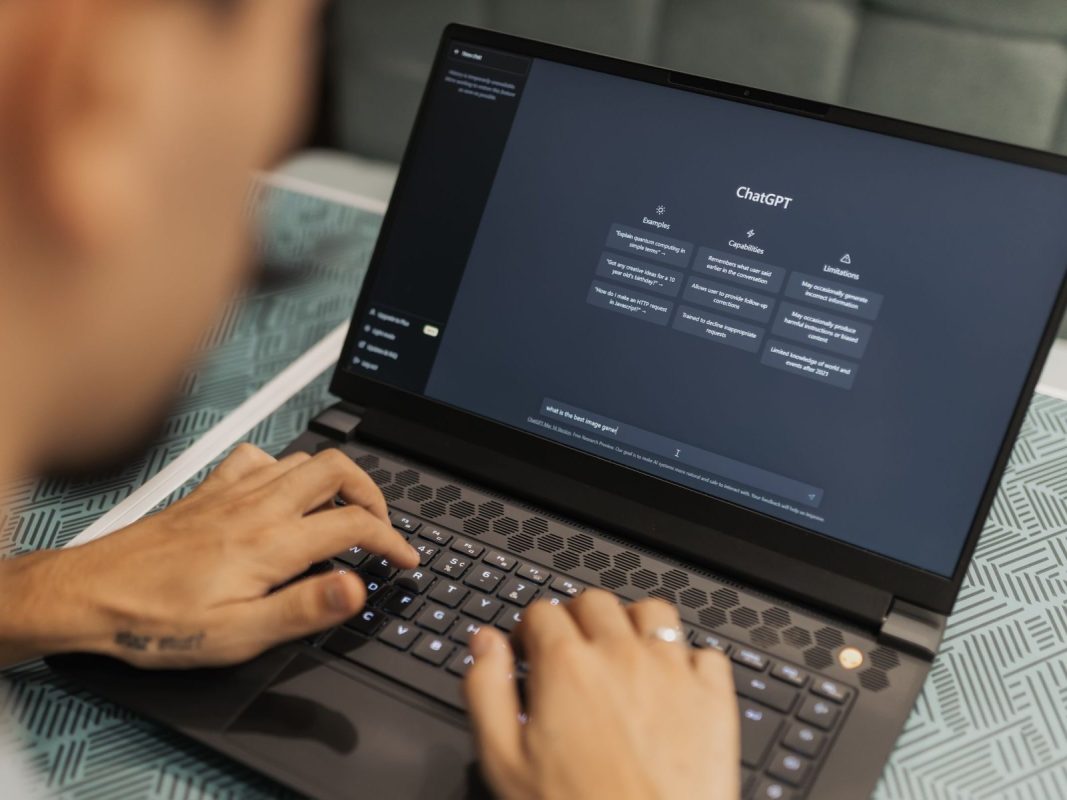
OpenAI резко снизила цены на модели GPT-5.6
OpenAI объявила о масштабном снижении цен на API для линейки GPT-5.6. Флагманом обновления стала самая доступная модель — GPT-5.6 Luna, которая подешевела сразу на 80%. Это важная новость для разработчиков и компаний, строящих AI-продукты на базе OpenAI.
Что изменилось и насколько
Изменения вступили в силу 30 июля. GPT-5.6 Luna — самый быстрый и бюджетный уровень — стал дешевле на 80%, а GPT-5.6 Terra, сбалансированная модель для повседневных задач, подешевела на 20%. Цены на подписки ChatGPT и Codex при этом остались прежними, однако использование Terra и Luna теперь расходует меньше кредитов в рамках этих тарифов.
Новый Fast mode для API
Одновременно OpenAI представила режим Fast mode для API, заменив им прежний уровень Priority Processing. Для GPT-5.6 Sol этот режим работает до 2,5 раза быстрее стандартного, стоит вдвое дороже, но не меняет качество ответов. Запросы, ранее помеченные как «priority», автоматически переходят на новый режим.
Как Luna выглядит на фоне конкурентов
По данным OpenAI, Luna теперь не уступает моделям, которые год назад считались передовыми, при этом обходясь примерно в 6% от их стоимости на задачу и работая почти в девять раз быстрее. На профессиональном бенчмарке Agents’ Last Exam компания заявляет, что Luna превосходит Claude Fable 5, а стоимость выполнения одной задачи при этом ниже почти на 99%.
На индексе Artificial Analysis v4.1 GPT-5.6 Luna набирает более 51 балла при цене около $0,05 за задачу — это сопоставимо или лучше, чем у конкурентов вроде Claude Opus 5 Low и Gemini 3.6 Flash, которые стоят в 5–10 раз дороже.
Как OpenAI добилась такой эффективности
Компания объясняет прогресс работой сразу на трёх уровнях: архитектура модели, системы инференса и агентный слой, связывающий модели с инструментами. Примечательно, что сам GPT-5.6 Sol участвовал в этом процессе: он автономно переписывал производственные ядра и провёл сотни экспериментов для повышения эффективности генерации токенов. Оптимизация ядер снизила сквозные затраты на обслуживание модели на 20%, а эксперименты повысили скорость генерации токенов более чем на 15%.
Снижение цен на фоне роста производительности говорит о том, что конкуренция на рынке AI API продолжает интенсивно развиваться — и разработчики от этого только выигрывают.
Источник: Notebookcheck
Похожие записи
ChatGPT для учёных: OpenAI даёт доступ 200 000 исследователям
OpenAI открывает бесплатный ChatGPT для 200 000 учёных по всему миру OpenAI расширяет программу ChatGPT for Academic Researchers — теперь доступ к передовым AI-инструментам смогут получить до 200…
Продолжить чтение
Qwen4-Max: флагманская AI-модель Alibaba с 2,4 трлн параметров
Alibaba представила Qwen4-Max: флагманская AI-модель с 2,4 трлн параметров Alibaba анонсировала Qwen4-Max — самую мощную модель в линейке Qwen на сегодняшний день. Новинка поддерживает нативную работу с изображениями…
Продолжить чтение
LVMH и OpenAI: стратегическое партнёрство в медиа
LVMH и OpenAI объединяются ради будущего журналистики Медиаподразделение LVMH заключило стратегическое партнёрство с OpenAI — один из крупнейших альянсов между люксовым медиахолдингом и компанией в сфере искусственного интеллекта.…
Продолжить чтение
Samsung Galaxy Claw: AI-агент для Galaxy-смартфонов
Samsung Galaxy Claw: AI-агент, который сам управляет вашим смартфоном Samsung активно развивает направление искусственного интеллекта, и похоже, что следующим шагом станет полноценный AI-агент, способный самостоятельно выполнять задачи на…
Продолжить чтение







