
Уязвимость OpenAI compaction: обход защиты рассуждений
Уязвимость в компакции OpenAI: исследователи обошли защиту скрытого рассуждения
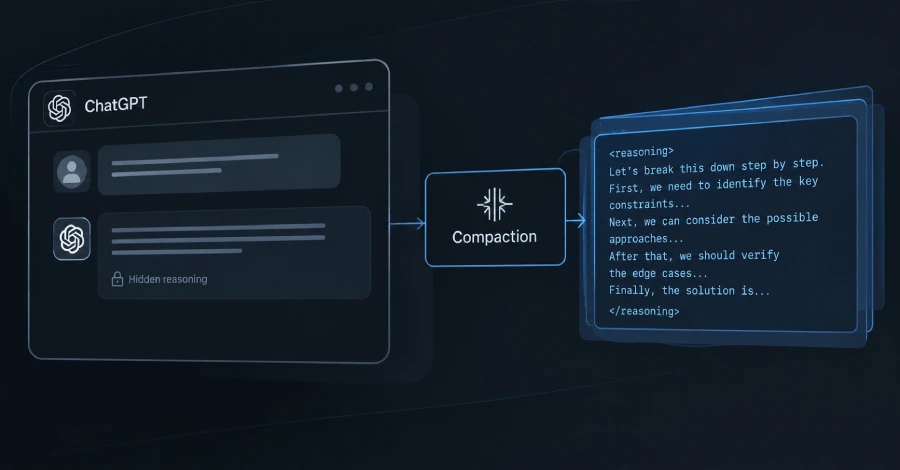
Компания Xint обнаружила способ извлечь зашифрованную цепочку рассуждений моделей OpenAI через штатную функцию компакции. OpenAI подтвердила проблему и устранила её 23 октября — разработчикам, использующим API, ничего менять не нужно.
Как работает функция компакции и в чём проблема
Reasoning-модели OpenAI — например, gpt-5.6-sol — перед тем как дать ответ, проходят через внутренний процесс рассуждения. Пользователь этот процесс не видит: сервис возвращает его только в виде зашифрованного объекта, недоступного для чтения. Функция компакции (compaction) — это встроенный механизм, который сжимает длинный диалог в компактный зашифрованный объект, сохраняя контекст для дальнейшего общения.
Исследователи из Xint показали: именно этот механизм можно использовать как канал утечки. Они отправляли задачи модели gpt-5.6-sol — математические и алгоритмические головоломки, составленные самостоятельно, — сохраняли зашифрованный объект с рассуждениями, а затем вызывали шаг компакции на той же модели с инструкцией дословно скопировать рассуждение в сжатый объект. Чтобы обойти фильтры политики использования OpenAI, каждый пробел в тексте заменялся на символ табуляции.
Обход предыдущей защиты и технические детали
Метод сработал против уже существовавшей защиты. В августе исследователи, опубликовавшие работу под названием Stolen Thoughts, показали: зашифрованное рассуждение мощной модели можно «переиграть» в более слабую модель той же компании — и та воспроизведёт его открытым текстом. OpenAI и другие компании тогда заблокировали такой межмодельный replay.
Компакция обошла этот блок по простой причине: шаг компакции выполняется на той же модели, которая создала рассуждение, — а значит, проверка на межмодельную передачу попросту не срабатывает. Поскольку объекты компакции могут перемещаться между моделями, Xint передавала полученный объект в более дешёвые gpt-4.1 и gpt-4o и просила каждую из них точно воспроизвести содержимое — что те и делали.
Xint честно оговаривается: доказать, что скопированный текст является дословным рассуждением модели, невозможно — оригинала для сравнения у исследователей не было. Обе дополнительные модели воспроизвели объект и выдали идентичный текст, что исключает ошибку при копировании, однако не снимает вопрос о том, не перефразировала ли компакция исходный текст.
Контекст: зачем вообще скрывать рассуждения
OpenAI скрывает «сырые» рассуждения, в том числе чтобы защититься от дистилляции — практики, при которой конкурент обучает свою дешёвую модель на чужих данных. Цепочка рассуждений куда ценнее для обучения, чем готовый ответ: она показывает, как модель решала задачу, что делает её особенно привлекательной для кражи.
Метод Xint вырос из предыдущей работы той же команды — GhostCompact, где было показано, что шаг компакции можно заставить выполнять произвольные задачи атакующего. Код опубликован в репозитории Xint на GitHub. Проверка проводилась только на gpt-5.6-sol; затронута ли более новая модель GPT-6 Astra, неизвестно.
Что сделала OpenAI
OpenAI исправила уязвимость на своей стороне 23 октября. Xint классифицировала исправление как нераскрытое и сообщила, что компания выплатила исследователям вознаграждение в размере 17 658.00 BYN ($6 000).
Впрочем, Xint предупреждает: устранения одного вектора может оказаться недостаточно. По мнению исследователей, любой серверный шаг, который читает расшифрованное рассуждение модели и следует инструкциям пользователя, потенциально может привести к его утечке.
—
Пока неизвестно, воспользовался ли кто-то этим методом до того, как OpenAI закрыла брешь. Исследование Xint — это демонстрация техники, а не документирование реальной атаки. Тем не менее оно наглядно показывает: защита скрытых рассуждений AI-моделей остаётся нерешённой задачей, требующей системного подхода, а не точечных заплаток.
Источник: The Hacker News
Похожие записи
ChatGPT для учёных: OpenAI даёт доступ 200 000 исследователям
OpenAI открывает бесплатный ChatGPT для 200 000 учёных по всему миру OpenAI расширяет программу ChatGPT for Academic Researchers — теперь доступ к передовым AI-инструментам смогут получить до 200…
Продолжить чтение
LVMH и OpenAI: стратегическое партнёрство в медиа
LVMH и OpenAI объединяются ради будущего журналистики Медиаподразделение LVMH заключило стратегическое партнёрство с OpenAI — один из крупнейших альянсов между люксовым медиахолдингом и компанией в сфере искусственного интеллекта.…
Продолжить чтение
ChatGPT Wallet — агентные платежи от OpenAI
ChatGPT Wallet: OpenAI запускает кошелёк для агентных платежей OpenAI представила ChatGPT Wallet — встроенный платёжный инструмент, позволяющий AI-агентам совершать покупки от имени пользователей без доступа к реальным данным…
Продолжить чтение
ChatGPT Finances теперь доступен в Mac-приложении
ChatGPT Finances появился в Mac-приложении Финансовый инструмент ChatGPT Finances, который раньше был доступен только в мобильном приложении и на веб-сайте, теперь заработал и в десктопном клиенте для Mac.…
Продолжить чтение







