
Nvidia DGX Spark: кластер из 8 систем с 1 ТБ памяти
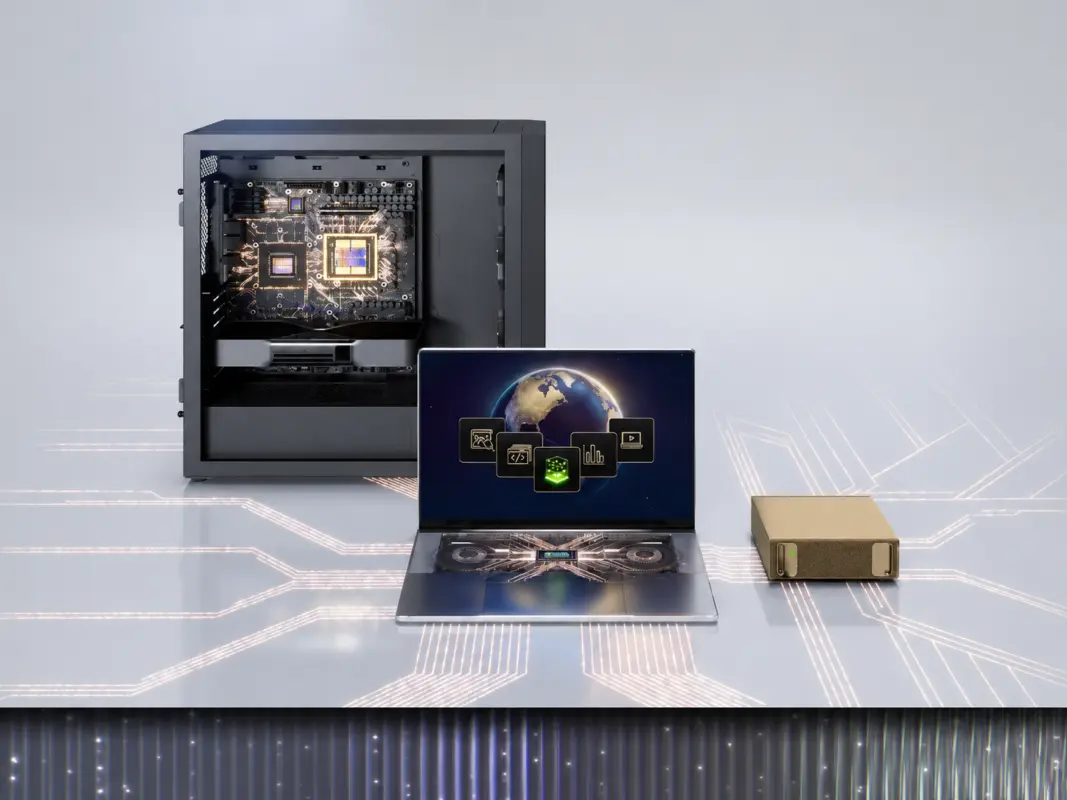
Nvidia DGX Spark: восемь систем объединяются ради 1 ТБ памяти
Nvidia расширила возможности своего AI-мини-ПК DGX Spark, открыв поддержку кластеров из восьми устройств с суммарным объёмом unified memory в 1 ТБ. Одновременно компания анонсировала программные оптимизации для ускорения агентных AI-задач и улучшения для линейки RTX.
Кластер из восьми DGX Spark — уже реальность
Анонс был сделан на GTC Berlin буквально накануне старта продаж новых 64 ГБ версий DGX Spark, которые поступили в продажу 23 октября. Логика масштабирования проста: восемь устройств с 128 ГБ unified memory каждое дают в сумме 1 ТБ, а кластер из восьми 64 ГБ-моделей обеспечивает до 512 ГБ общей памяти.
По словам Nvidia, такой объём открывает доступ к работе с более крупными AI-моделями, расширенными контекстными окнами и одновременным запуском нескольких AI-агентов. В частности, компания называет GLM 5.3 в числе моделей класса frontier, которые выигрывают от конфигурации на 1 ТБ.
ConnectX-7 и утилита Nvidia Sync
Взаимодействие между устройствами в кластере организовано через встроенные сетевые адаптеры ConnectX-7. Однако пока восьмиузловые конфигурации требуют ручной настройки — автоматическая поддержка появится в утилите Nvidia Sync в конце октября. Вместе с ней выйдет функция Model Launcher, которая упростит загрузку совместимых моделей, их развёртывание на нескольких системах и подключение через инструменты вроде OpenCode.
Программные оптимизации и прирост производительности
Помимо кластерных возможностей, Nvidia сообщила о конкретных улучшениях производительности. DGX Spark при работе с Qwen3.8 27B прибавляет до 30% в скорости, тогда как DGX Station демонстрирует прирост пропускной способности до 20% при работе с GLM 5.3 Flash. GPU RTX PRO 6000 Blackwell, по данным компании, выполняет агентные задачи с Qwen 3.8 Flash Next до 40% быстрее — благодаря усовершенствованиям в области speculative decoding, разработанным совместно с сообществами llama.cpp и vLLM.
Стоит оговориться: все эти цифры относятся к конкретным моделям и сценариям нагрузки, а не являются универсальными показателями прироста. Данных о масштабировании производительности в восьмиузловых кластерах Nvidia в своём анонсе не привела.
Оптимизированные чекпоинты и цены на новые модели
Nvidia также представила новую коллекцию AI-чекпоинтов с оптимизацией под доступную память: в частности, FP4-варианты Qwen3 Flash Next и GLM 5.3 Flash. Их задача — снизить потребление памяти и освободить больше места под KV-кэш, что особенно актуально при работе с длинными контекстными окнами.
Новые 64 ГБ версии DGX Spark сохраняют тот же SoC GB10 Grace Blackwell Superchip и стартуют с цены 14 853.53 BYN ($4 999) — любопытное совпадение, ведь именно столько совсем недавно стоила 128 ГБ модель.
Вывод: Поддержка восьмиузловых кластеров делает DGX Spark куда интереснее для серьёзных локальных AI-задач, однако практическую эффективность такой конфигурации ещё предстоит оценить — официальных бенчмарков для кластерных сценариев Nvidia пока не предоставила.
Источник: Notebookcheck
Похожие записи
ChatGPT для учёных: OpenAI даёт доступ 200 000 исследователям
OpenAI открывает бесплатный ChatGPT для 200 000 учёных по всему миру OpenAI расширяет программу ChatGPT for Academic Researchers — теперь доступ к передовым AI-инструментам смогут получить до 200…
Продолжить чтение
Qwen4-Max: флагманская AI-модель Alibaba с 2,4 трлн параметров
Alibaba представила Qwen4-Max: флагманская AI-модель с 2,4 трлн параметров Alibaba анонсировала Qwen4-Max — самую мощную модель в линейке Qwen на сегодняшний день. Новинка поддерживает нативную работу с изображениями…
Продолжить чтение
LVMH и OpenAI: стратегическое партнёрство в медиа
LVMH и OpenAI объединяются ради будущего журналистики Медиаподразделение LVMH заключило стратегическое партнёрство с OpenAI — один из крупнейших альянсов между люксовым медиахолдингом и компанией в сфере искусственного интеллекта.…
Продолжить чтение
Gemini Live получит видеоэффекты с Пикачу и тыквами
Gemini Live получит видеоэффекты с Пикачу и тыквами В коде приложения Google обнаружили скрытую функцию Genie — она позволит накладывать анимированные AI-эффекты прямо на живое изображение с камеры…
Продолжить чтение







