
Mercury 3 — диффузионная модель быстрее GPT-6 Luna
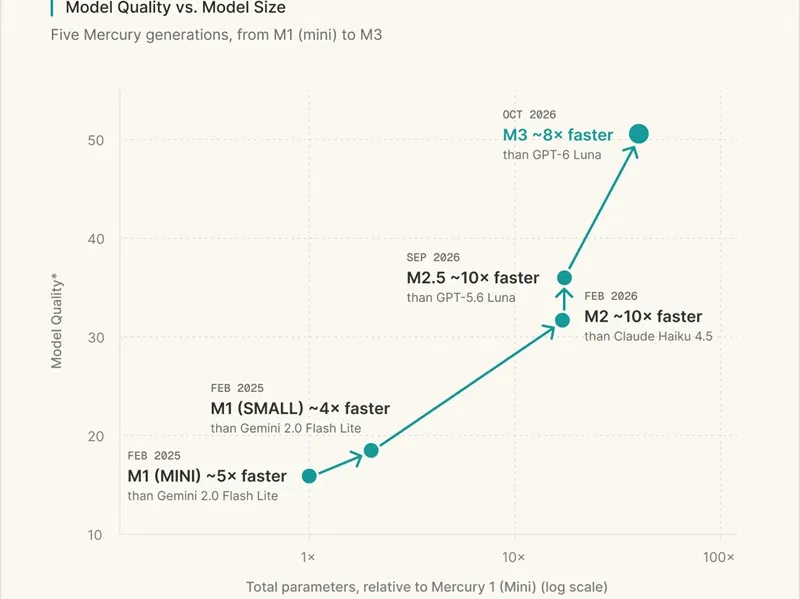
Mercury 3: диффузионная языковая модель быстрее GPT-6 Luna в 8 раз
Компания Inception из Редвуд-Сити представила Mercury 3 — диффузионную большую языковую модель (dLLM) нового поколения, которая объединяет то, что раньше казалось несовместимым: высокую производительность и рекордную скорость генерации. Это важно для всех, кто строит приложения на базе ИИ и устал выбирать между качеством и откликом.
Параллельная генерация вместо последовательной
Принципиальное отличие dLLM от обычных больших языковых моделей — в архитектуре генерации. Стандартные LLM выдают текст токен за токеном, строго по одному. Диффузионные модели работают иначе: они формируют сразу несколько токенов одновременно, что принципиально меняет скоростные характеристики. Mercury 3 развивает эту идею до предела — скорость генерации превышает 1000 токенов в секунду.
Генеральный директор Inception Стефано Эрмон прокомментировал это лаконично: «Ответы от таких моделей приходят практически мгновенно».
Что нового в Mercury 3
Mercury 3 — четвёртая модель в линейке, которая стартовала с Mercury 1 в июне 2025 года. Каждое поколение прибавляло в возможностях, не теряя в скорости: Mercury 2 получила механизмы логического рассуждения, Mercury 2.5 — настраиваемое рассуждение и контекстное окно на 260 тысяч токенов. Новая версия делает самый значительный шаг: контекстное окно выросло почти в четыре раза — до 1 миллиона токенов, а сам размер модели увеличился в 40 раз по сравнению с первой Mercury.
Сравнение с конкурентами
По внутренним тестам Inception, Mercury 3 по ряду показателей опережает GPT-6 Luna от OpenAI, Claude Haiku 5.5 от Anthropic и GLM-5.3 Flash от Zhipu. При этом модель работает в 4–8 раз быстрее, чем эти аналоги. Разработчики подчёркивают, что раньше перед командами стоял выбор: взять компактную быструю модель или мощную, но медленную. Mercury 3, по их словам, закрывает этот компромисс.
Доступность и стоимость
Модель уже доступна через Inception API, а также на платформах Baseten, OpenRouter и Vercel. Важный плюс для разработчиков — совместимость с API OpenAI: переход на Mercury 3 не требует переписывать существующий код.
Стандартные тарифы: 0.60 BYN ($0.20) за миллион входных токенов и 2.09 BYN ($0.70) за миллион выходных. На старте Inception снизила расценки вдвое — до 0.30 BYN ($0.10) и 1.05 BYN ($0.35) соответственно.
Mercury 3 выглядит как серьёзная заявка на рынке быстрых языковых моделей: сочетание миллионного контекста, скорости свыше 1000 токенов в секунду и конкурентоспособного качества делает её интересным вариантом для задач, где задержка критична.
Источник: 3dnews.ru
Похожие записи
ChatGPT для учёных: OpenAI даёт доступ 200 000 исследователям
OpenAI открывает бесплатный ChatGPT для 200 000 учёных по всему миру OpenAI расширяет программу ChatGPT for Academic Researchers — теперь доступ к передовым AI-инструментам смогут получить до 200…
Продолжить чтение
Qwen4-Max: флагманская AI-модель Alibaba с 2,4 трлн параметров
Alibaba представила Qwen4-Max: флагманская AI-модель с 2,4 трлн параметров Alibaba анонсировала Qwen4-Max — самую мощную модель в линейке Qwen на сегодняшний день. Новинка поддерживает нативную работу с изображениями…
Продолжить чтение
LVMH и OpenAI: стратегическое партнёрство в медиа
LVMH и OpenAI объединяются ради будущего журналистики Медиаподразделение LVMH заключило стратегическое партнёрство с OpenAI — один из крупнейших альянсов между люксовым медиахолдингом и компанией в сфере искусственного интеллекта.…
Продолжить чтение
Samsung Galaxy Claw: AI-агент для Galaxy-смартфонов
Samsung Galaxy Claw: AI-агент, который сам управляет вашим смартфоном Samsung активно развивает направление искусственного интеллекта, и похоже, что следующим шагом станет полноценный AI-агент, способный самостоятельно выполнять задачи на…
Продолжить чтение







